本节最重要的目标,是理解为什么系统需要消息队列,以及使用它之后,如何保证业务正确性。
为什么后端需要消息队列?
假设我们继续开发之前的电商网站, 用户购买了一副无线耳机,点击「提交订单」,此时,后端需要完成以下工作:
| 业务操作 | 假设耗时 |
|---|---|
| 检查并扣减库存 | 20 ms |
| 创建订单 | 30 ms |
| 调用邮件服务发送通知 | 500 ms |
| 更新用户积分 | 100 ms |
| 记录运营统计 | 50 ms |
1. 最直观的实现:同步执行
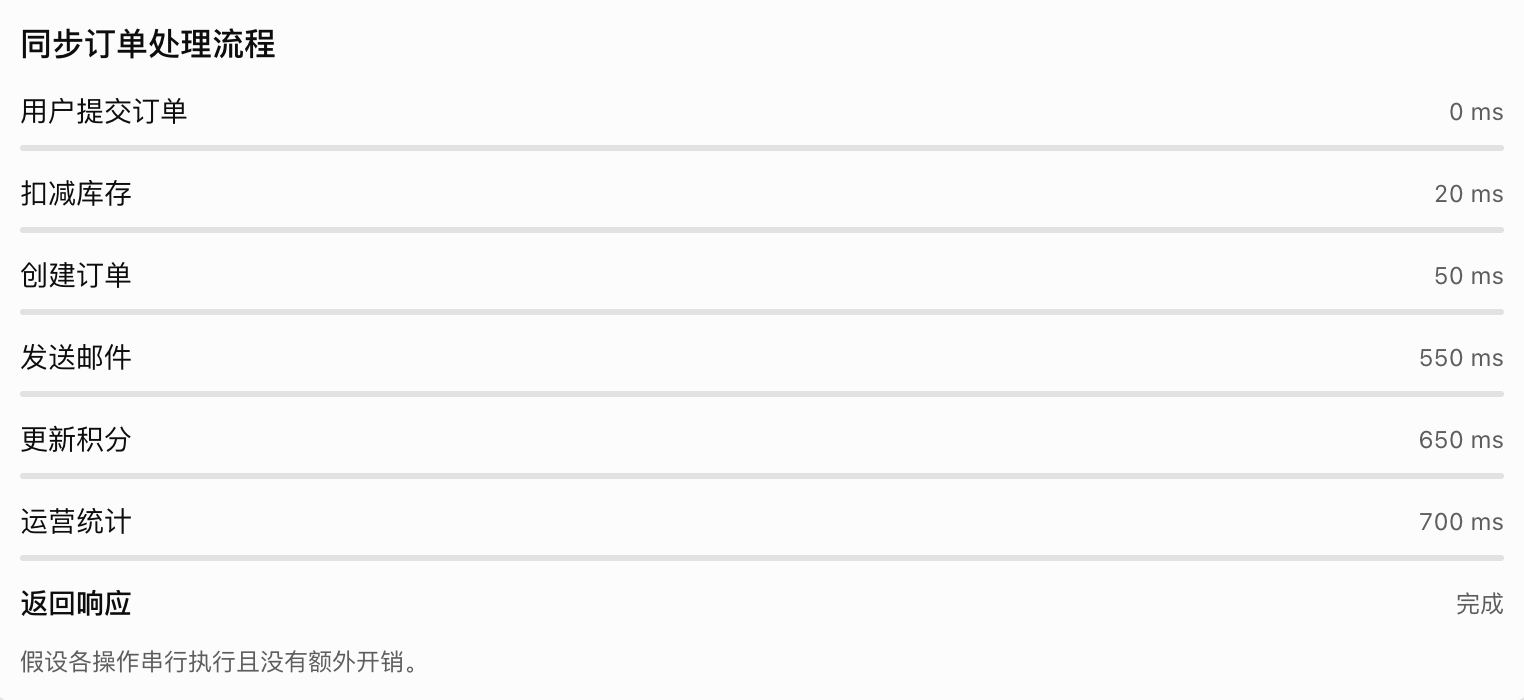
用户只是想知道订单是否创建成功,为什么要等待邮件发送、积分更新和数据统计?
应该区分两类操作:
- 核心同步操作:库存扣减、订单创建、必要的业务校验。这些操作决定订单是否成功,通常需要立即完成,并通过 MySQL 事务保证正确性。
- 可以异步执行的操作:发送通知、非即时的积分处理、运营统计。这些工作可以交给其他服务稍后执行。
2. 引入消息队列
把非关键路径上的工作从下单请求中拆出去。
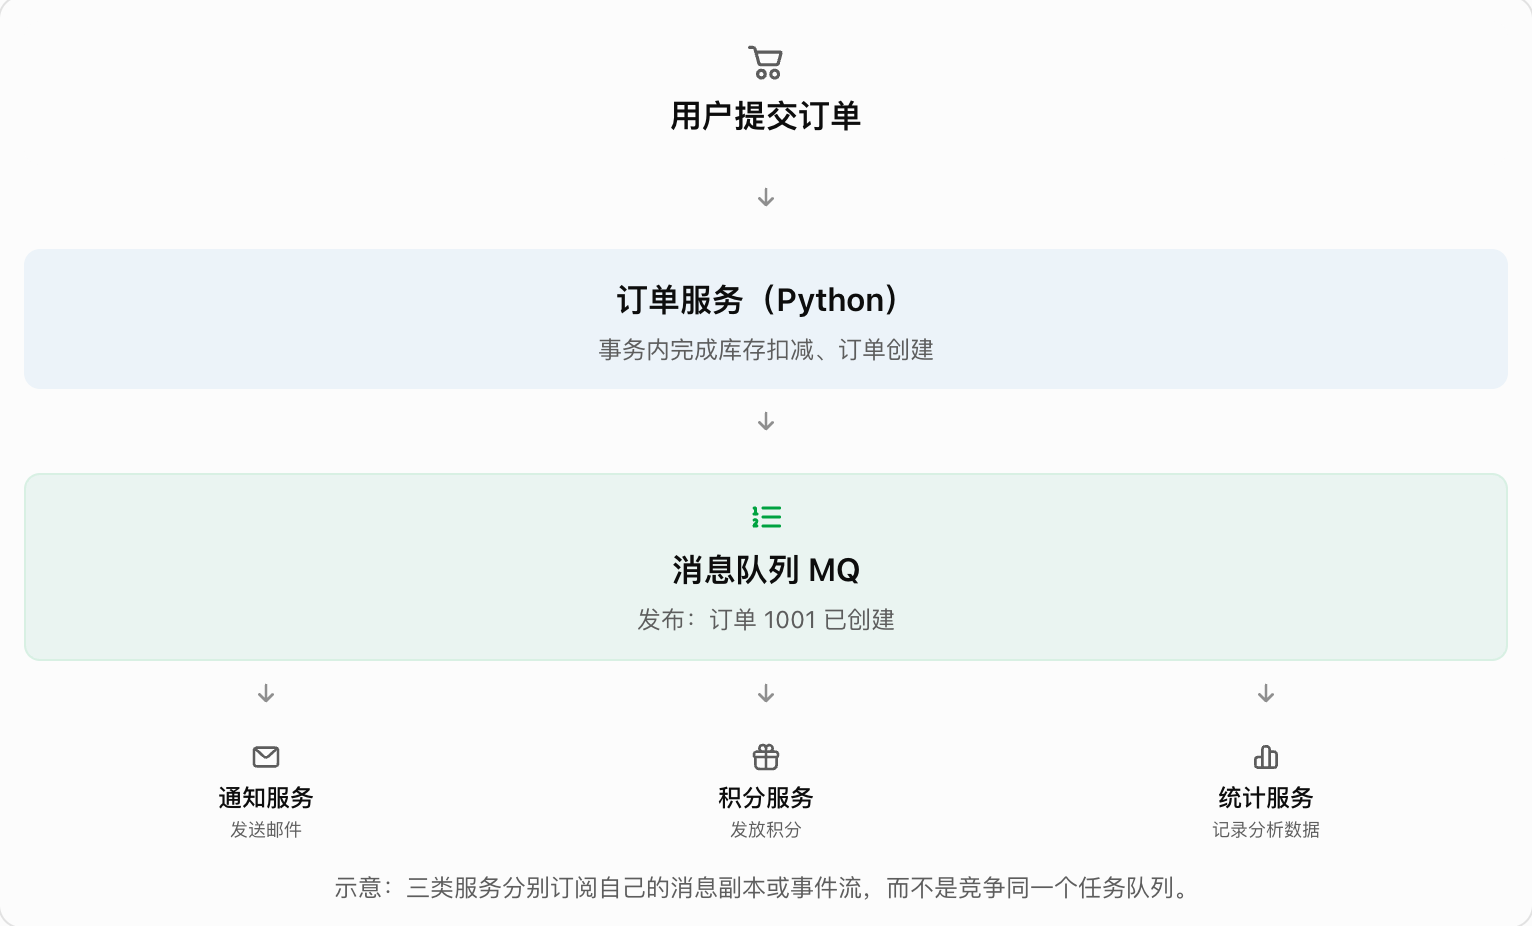
订单服务不再等待每一项后续操作真正完成,而是把待处理的事件可靠地交给消息系统,确认核心订单事务成功、消息已可靠安排发布后,它就能返回响应。
这里有一个重要细节:订单提交与消息发布之间也可能失败。 后面会用 Transactional Outbox 模式解决它。
3. MQ 的三大作用
| 作用 | 不使用 MQ | 使用 MQ |
|---|---|---|
| 异步处理 | 用户等待所有操作完成 | 非关键任务后台执行 |
| 解耦 | 订单服务直接调用通知、积分等服务 | 订单服务发布事件,由订阅者自行处理 |
| 削峰填谷 | 突发任务直接冲击下游 | 任务进入队列,消费者按处理能力逐步消化 |
削峰填谷是什么意思?
假设电商平台正在举行秒杀活动, 平时每秒只有 100 个订单,但活动开始时每秒出现 1,000 个订单, 邮件服务一秒最多只能处理 200 封通知邮件。
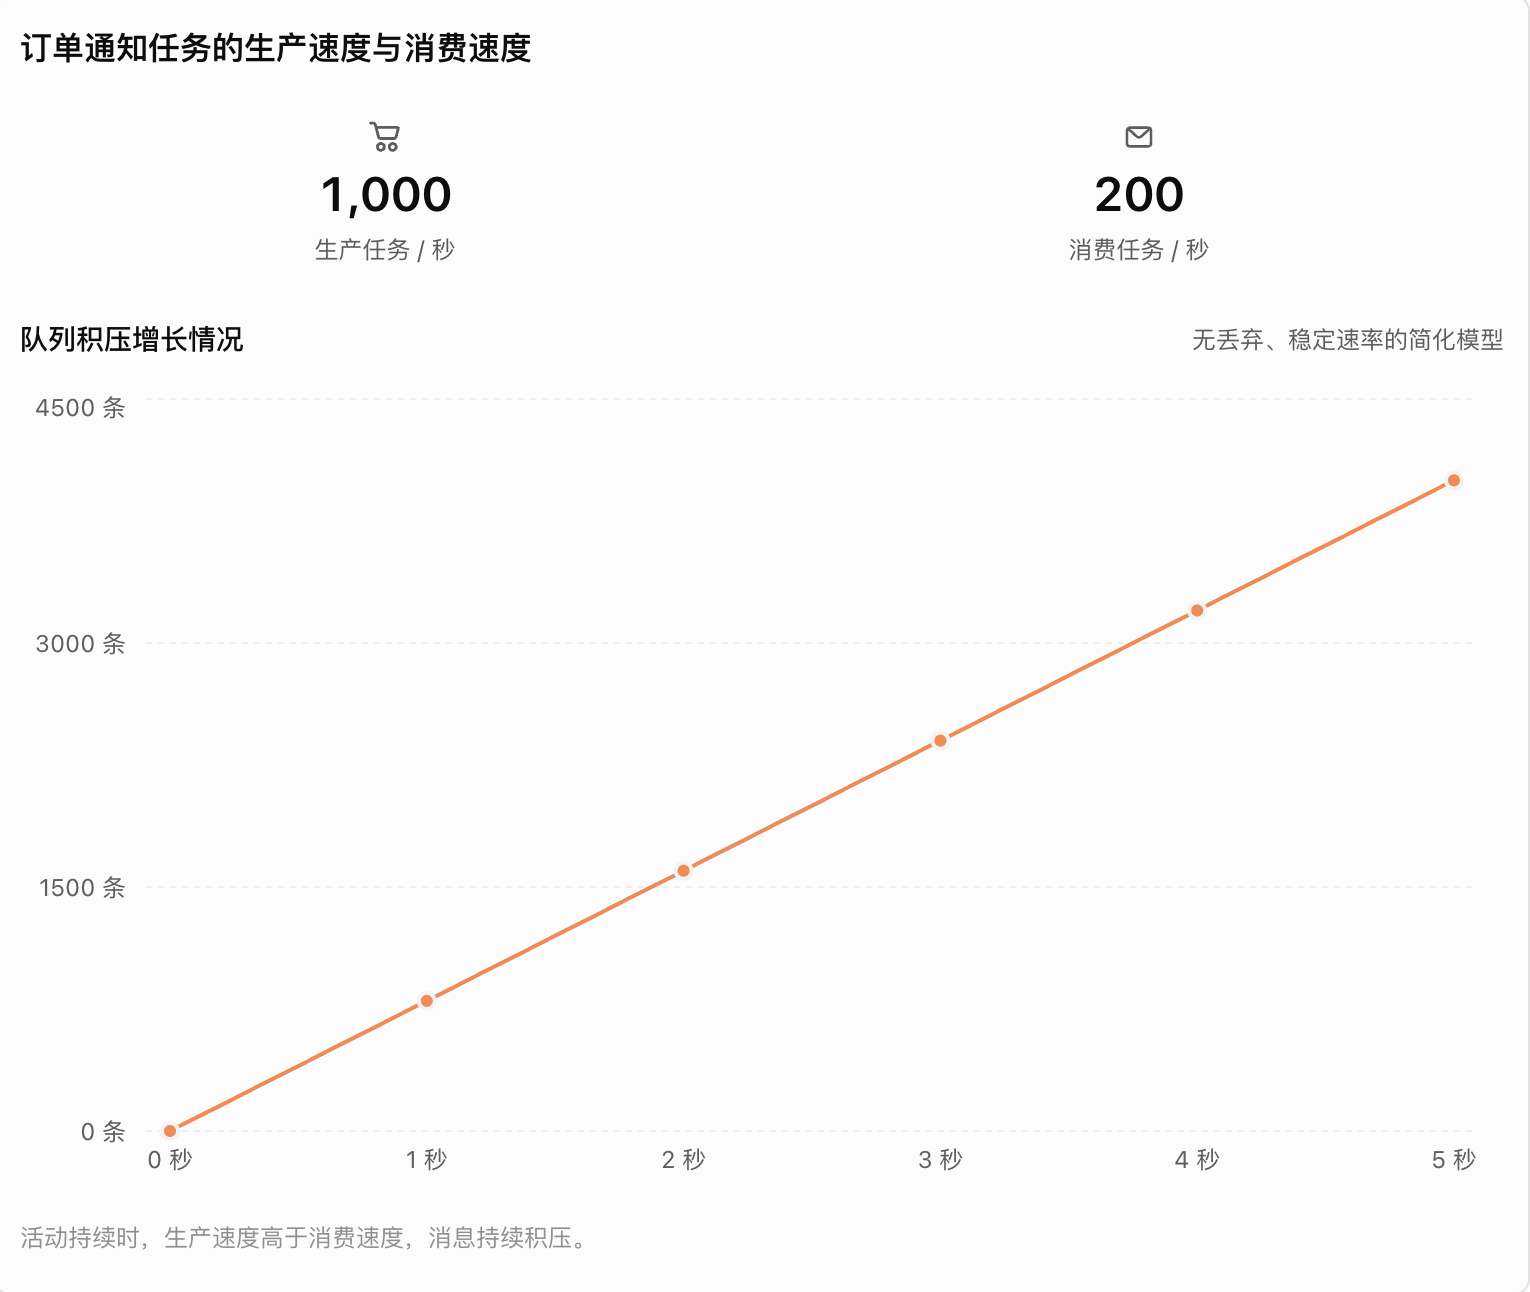
MQ 的作用不是让邮件服务突然获得处理 1,000 封邮件的能力, 它把来不及处理的任务暂时保存起来, 秒杀结束后,新增任务量下降,消费者再逐渐处理积压任务。
如果任务长期持续产生得比消费速度快,MQ 并不能解决容量不足的问题。
队列会越来越长,占用更多存储,用户等待时间也会越来越久。
此时需要增加消费者、优化处理速度、做背压或限流等操作。
理解 MQ 中的核心角色
无论 RabbitMQ 还是 Kafka,都存在三个基本角色。
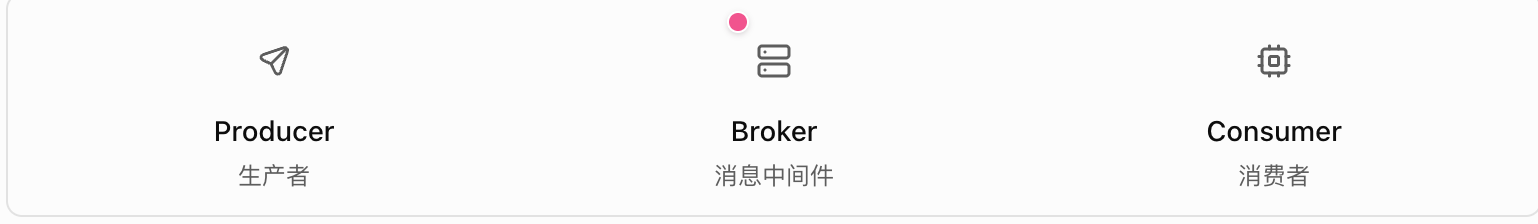
- Producer(生产者):创建并发布消息的应用,例如订单服务。
- Broker(消息代理):接收、存储、路由或分发消息的系统,例如 RabbitMQ、Kafka Broker。
- Consumer(消费者):接收或读取消息,并执行相应业务逻辑的程序,例如邮件通知服务。
消息应该长什么样?
不要简单发送一个字符串 "下单成功"。更合理的是发送一个包含业务信息的事件:
{
  "event_id": "evt-8b37c2",
  "event_type": "order.created",
  "version": 1,
  "order_id": 1001,
  "user_id": 7,
  "occurred_at": "2026-10-18T12:00:00Z"
}
event_id:事件的唯一 ID,用于去重和幂等。event_type:消费者知道这是什么事件。version:帮助处理事件结构将来的变化。order_id:消费者知道需要处理哪个订单。occurred_at:用于日志、追踪、排查故障。
没有把邮件地址、收货地址等所有用户数据塞进消息里。通常只应携带消费者必要的数据,尽量避免敏感信息在消息系统中无谓扩散。
一个需要分清的地方:事件与任务
order.created表达的是一件已经发生的事实。send_order_email表达的是一个需要执行的命令或任务。
它们经常都通过 MQ 传输,但语义不同, 事件适合让多个服务各自作出反应;任务通常由特定消费者负责执行, 这是后面理解 RabbitMQ 的路由方式与 Kafka 的消费模型的关键。
RabbitMQ 与 Kafka 到底有什么区别?
它们都是消息系统,但设计侧重点不同。
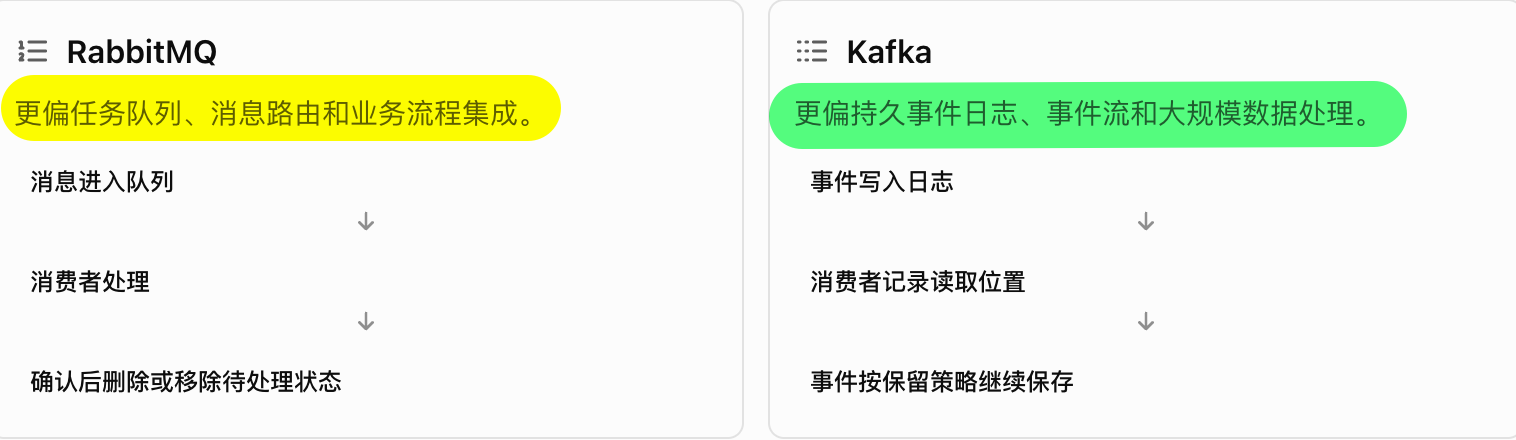
RabbitMQ:重点理解 Exchange 和 Queue
RabbitMQ 中一个容易误解的地方是,消息通常不是直接交给消费者的。
以 AMQP 0-9-1 模型为例:
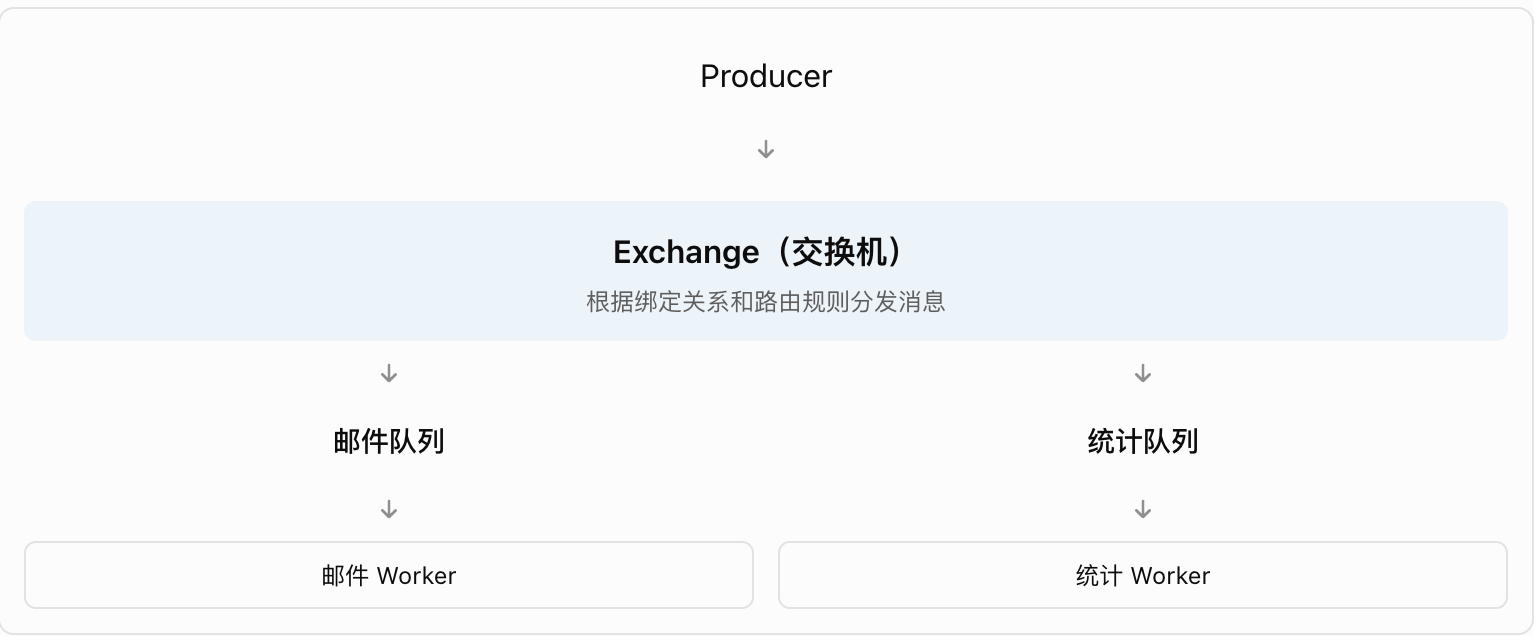
例如,希望一次订单创建事件,同时触发通知服务和统计服务。
就可以使用 Fanout Exchange,让消息分别进入两个队列。
Exchange 可以采用不同的路由模式:
| 类型 | 作用 |
|---|---|
| Direct | 根据 Routing Key 精确匹配 |
| Fanout | 向绑定的所有队列发送副本 |
| Topic | 根据带通配符的路由模式匹配 |
| Headers | 根据消息头属性路由 |
如果两个消费者监听的是同一个普通任务队列,它们通常是在竞争处理消息,而不是各自收到一份。
Kafka:理解 Topic、Partition 和 Offset
Kafka 的基本模型不太一样, 它将事件写入 Topic(主题),Topic 可以分为多个 Partition(分区),每个分区里的消息按照顺序追加。
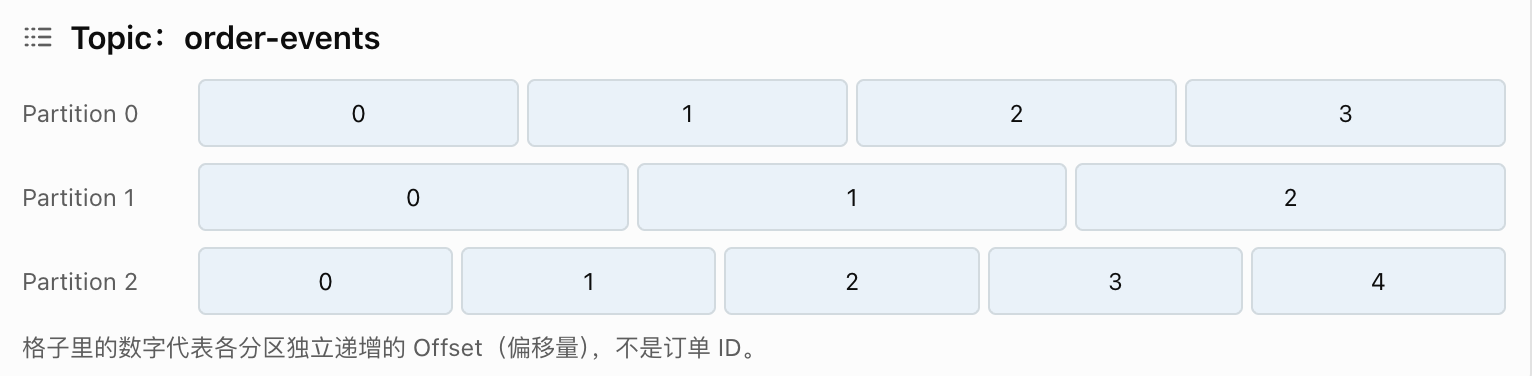
- Topic:事件主题,例如
order-events。 - Partition:Topic 的分区。Kafka 依靠分区实现数据分布和并行处理。
- Offset:一条事件在其分区日志中的位置。消费者利用 Offset 跟踪消费进度。
例如消费者处理到了 Partition 0 的 Offset 2,正常继续消费时,就从后续位置读取。
Kafka 的一个重要特点是:消费者读完事件之后,事件通常不会立即删除,而是按照 Topic 的保留策略继续保存。
只要事件仍在保留范围内,消费者就可以重新读取历史数据, Kafka 对单个分区内的事件提供顺序保证,不提供跨多个分区的全局顺序保证。
Consumer Group:为什么 Kafka 也能分工?
假设订单事件要由两个系统处理:通知服务和数据分析服务。
可以创建两个 Consumer Group:
notification-groupanalytics-group
它们各自维护消费进度,因此都可以读取同一批订单事件。
如果通知服务内部有多个 Worker,并且都属于同一个 Consumer Group,Kafka 会把 Topic 的分区分配给组内的消费者,让它们协同处理。
普通 Consumer Group 模型下,同一个分区在同一时刻由组内一个消费者负责读取,因此分区数量也会限制该消费组的并行度。
在事件仍处于保留期内、这个新的消费组没有已经提交的 Offset 时,第二个消费者组也能读取先前发送的事件, 这是因为 Kafka 的不同消费组可以独立维护读取位置。
RabbitMQ 普通工作队列中的一条消息一旦被成功 ACK 并移除,其他晚加入的消费者不会自动重新读到它。
这就是 Kafka 适合事件流处理、历史事件回放和独立数据分析任务的重要原因。
怎么对比?
| 比较维度 | RabbitMQ | Kafka |
|---|---|---|
| 核心模型 | 交换机、队列、消费者 | Topic、Partition、Offset |
| 典型用途 | 异步任务、业务消息路由 | 事件流、日志采集、实时数据处理 |
| 消费后 | 普通队列消息确认后移除 | 事件按保留策略保存 |
| 重放历史 | 需要特定设计,普通队列不以此为核心 | 原生支持在保留期内重新消费 |
| 多消费者 | 同队列竞争、不同队列独立订阅 | Consumer Group 协同消费 |
| 顺序性 | 取决于队列、消费者及重投递行为 | 单个 Partition 内有序 |
不是说 RabbitMQ 一定性能低,或者 Kafka 永远更好。选择取决于具体业务模型、路由要求、事件保留需求、可靠性与运维成本。
对于我们现在的实习学习项目,先用 RabbitMQ 建立对生产者、消费者和消息确认的理解,再把概念映射到 Kafka,会比较容易。
最重要的部分:如何保证消息可靠性?
现在考虑:已经让订单服务把消息发送给 RabbitMQ,邮件服务负责消费。
但是如果机器突然宕机、网络断开,消息会不会丢失?这是使用 MQ 后必须面对的问题。
将一条消息的生命周期拆成三个阶段:
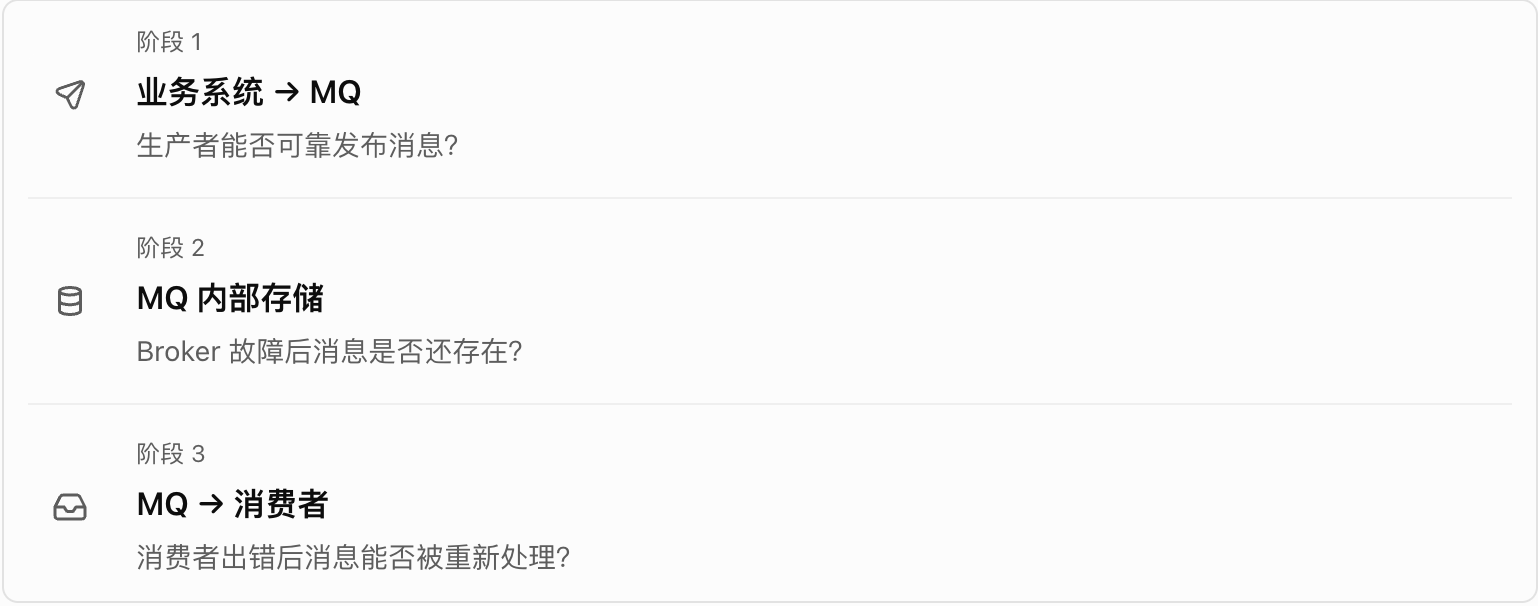
生产者:Publisher Confirm
生产者发送一条消息后,不能仅仅因为 Python 没有报错,就认为消息已经可靠存储了。
channel.basic_publish(
    exchange="",
    routing_key="order.notify",
    body=message,
)
网络连接可能在发送过程中中断, 客户端也可能不知道 RabbitMQ 是否已经接收消息。
RabbitMQ 提供了 Publisher Confirms(发布确认)机制,用于让生产者知道 Broker 是否已对消息承担相应责任。
生产者没有收到确认时,可以按照策略重试, 不过未收到确认不等于 Broker 一定没有收到消息,重试有可能产生重复消息。
Broker:持久化消息
RabbitMQ 中两个常见配置是:
# 声明持久化队列
channel.queue_declare(
    queue="order.notify",
    durable=True #durable=True 用于让队列定义在 Broker 重启后仍能保留。
)

# 发送持久化消息
properties = pika.BasicProperties(
    delivery_mode=pika.DeliveryMode.Persistent #Persistent 表示希望消息持久化保存。
)
持久化队列不等于队列里每条消息都是持久化的。
消费者:ACK 确认
假设邮件消费者已经拿到一个任务,但还没来得及发送邮件,进程就崩溃了, 这时候消息怎么办?
RabbitMQ 提供了 ACK(Acknowledgement)机制。
消费者处理完成后,可以主动通知 Broker:
这条消息我已经处理好了,可以移除它了。
channel.basic_ack(
    delivery_tag=method.delivery_tag
)
如果消费者崩溃并且消息尚未 ACK,RabbitMQ 通常会在发现连接关闭后,将未确认的消息重新安排投递。 通常使用手动 ACK,即 `auto_ack=False`。
ACK 的时机
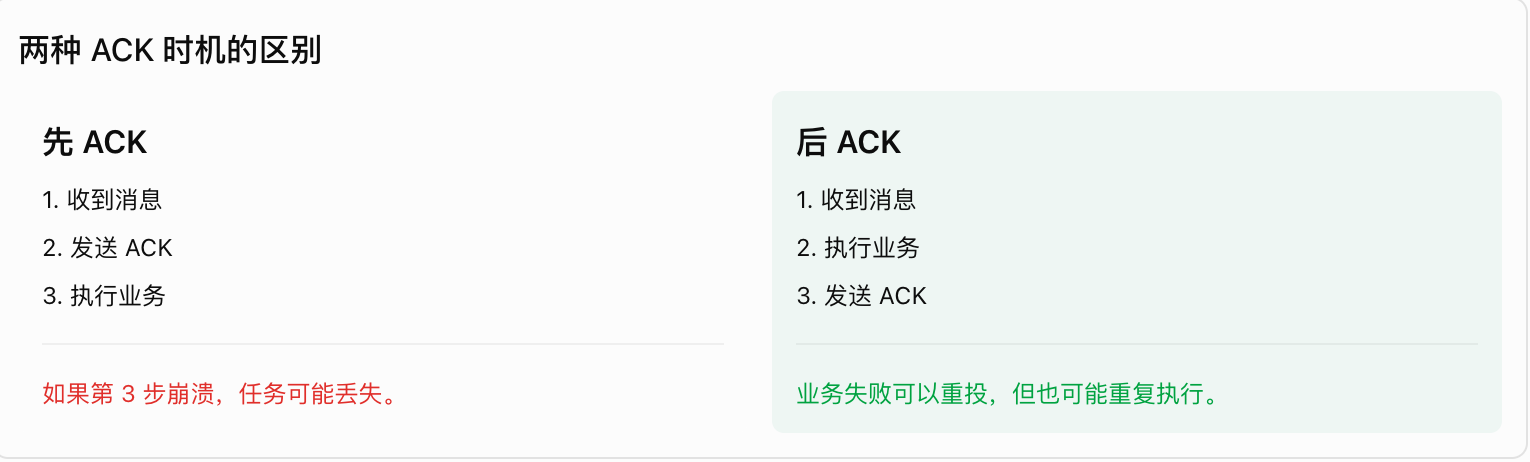
某个消费者已经成功向数据库写入了业务结果,但在发送 ACK 之前突然崩溃。它重启之后可能发生什么?
A. RabbitMQ 一定知道业务执行成功,不会再次投递
B. 消息可能重新投递,导致业务再次执行
C. 数据库一定自动回滚刚才的操作
数据库提交和 RabbitMQ ACK 是两个独立动作。业务可能已经成功执行,但 Broker 没收到确认,因此重新投递消息。这就是接下来要处理的重复消费问题。
为什么消息可能重复?什么是幂等性?
三种消息处理语义。
| 语义 | 核心含义 |
|---|---|
| At-most-once | 最多处理一次,允许遗漏 |
| At-least-once | 至少处理一次,允许重复 |
| Exactly-once | 在定义好的处理范围内,效果恰好发生一次 |
实际工程中,“至少一次投递 + 消费者幂等”是非常常见的设计思路。
幂等(Idempotency)
对于同一个业务操作,重复执行一次或多次,最终业务效果与执行一次相同,就称为幂等。
如何实现幂等?
一个常见方案是给事件分配唯一 ID,再由消费者保存处理记录。
CREATE TABLE processed_events (
    consumer_name VARCHAR(50) NOT NULL,
    event_id VARCHAR(100) NOT NULL,
    PRIMARY KEY (consumer_name, event_id)
) ENGINE=InnoDB;
假设有积分服务消费,先尝试往 processed_events 插入记录, 如果插入成功,说明这条事件尚未被该消费者成功登记处理。
不能只是先 SELECT 判断有没有处理过,再 INSERT。因为多个消费者并发时,可能同时查到“尚未处理”。
更可靠的做法是使用数据库的唯一约束进行并发去重,而且要让去重记录和积分修改进入同一个事务。
START TRANSACTION;

INSERT INTO processed_events
(consumer_name, event_id)
VALUES ('points', 'evt-1001');

UPDATE users
SET points = points + 100
WHERE id = 7;

COMMIT;
这里最重要的思想是:
去重记录与业务操作必须在同一事务中完成。
进阶:为什么有了消息确认,订单事件还是可能丢失?
前面实现了生产者确认、持久化消息和消费者 ACK。
假设订单服务这样执行:
def create_order():
    # 1. 创建订单并提交 MySQL 事务
    save_order_to_mysql()

    # 2. 发布订单事件
    publish_order_event()

    return "下单成功"
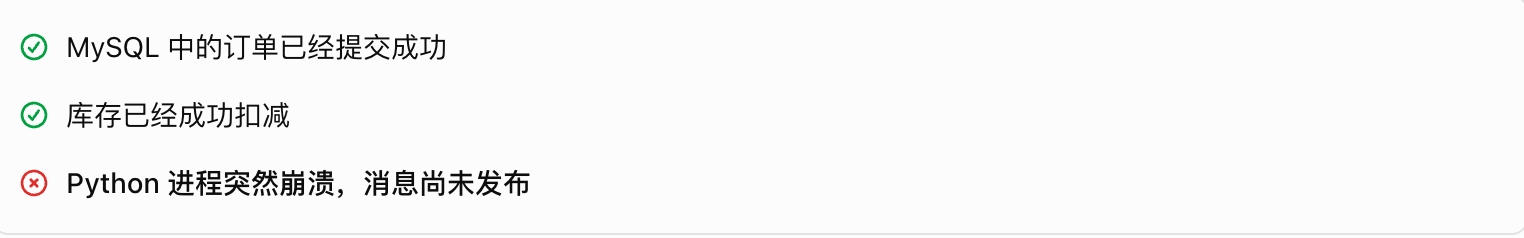
数据库中已经有订单,但是 MQ 中没有对应事件, 通知服务永远不知道这个订单存在, 与 RabbitMQ 的 Publisher Confirm 是否可靠没有直接关系,因为消息甚至还没来得及发送。
Transactional Outbox(事务发件箱)
核心思想是:让业务数据和待发送的事件先保存在同一个数据库事务里。
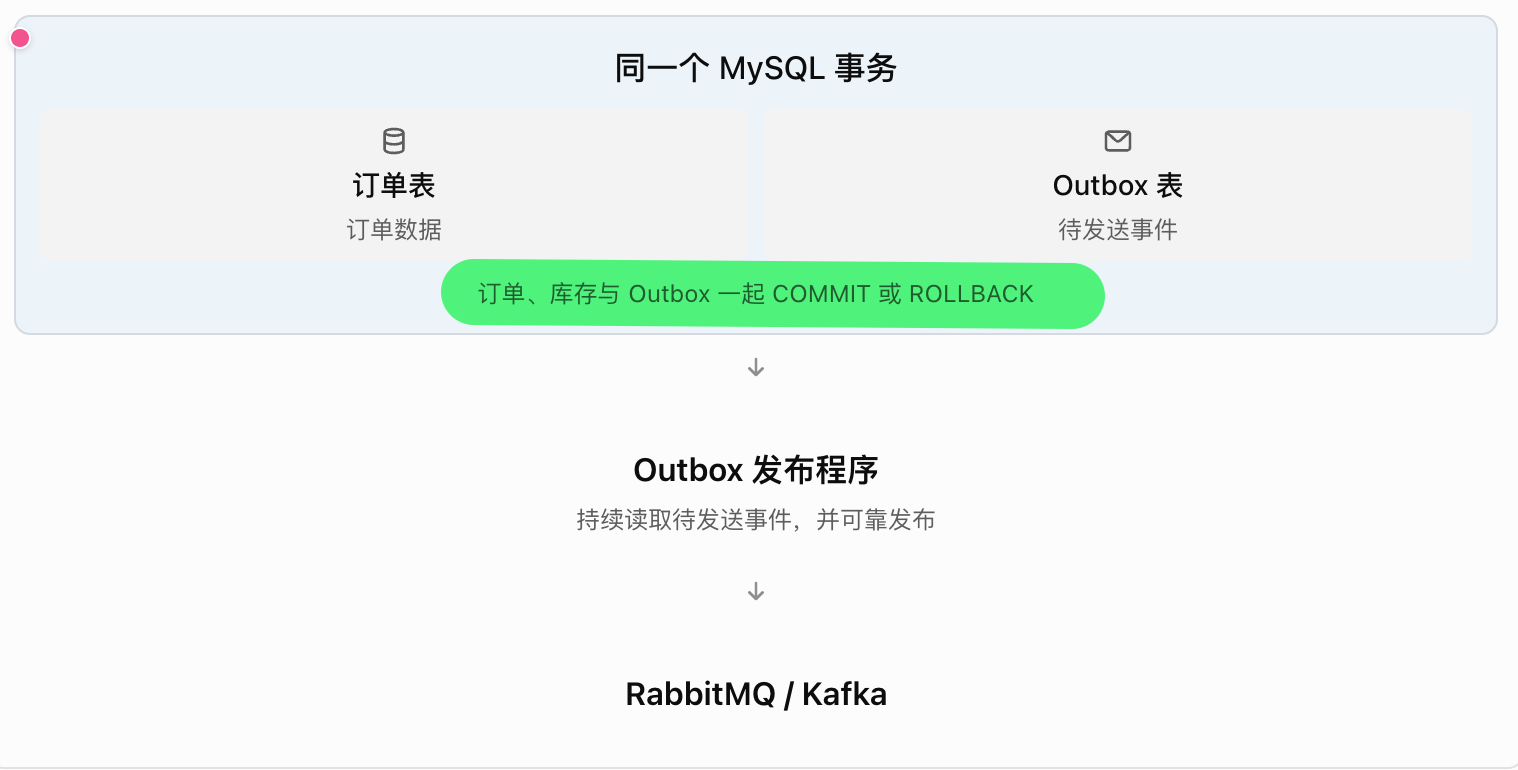
当用户下单时,在同一个事务中完成: 订单创建、库存扣减、Outbox 事件写入。
不过仍存在一个边界情况:
Broker 已收到消息 → 发布程序还未将 Outbox 标记为已发布 → 发布程序崩溃。
此时程序重启可能再次发送这条消息。
所以 Outbox 解决的是业务事务与消息发布之间的可靠衔接,并不自动消除重复消息。
这也是为什么:
Transactional Outbox + At-least-once + 消费端幂等 是一种非常有价值的工程组合。
消息队列并没有消灭复杂性,而是把原来同步执行的问题,转换成了异步状态、重试、重复消费和最终一致性等问题。