能真正理解三个问题:
- 存得住:如何设计数据表,使用 SQL 管理数据?
- 改得对:多人同时修改数据,如何避免超卖、丢失更新?
- 查得快:一张表有几百万条数据,MySQL 为什么还能迅速查到需要的记录?
这三个问题分别对应数据库的基础操作、事务和索引。
亲手设计一个 MySQL 数据库
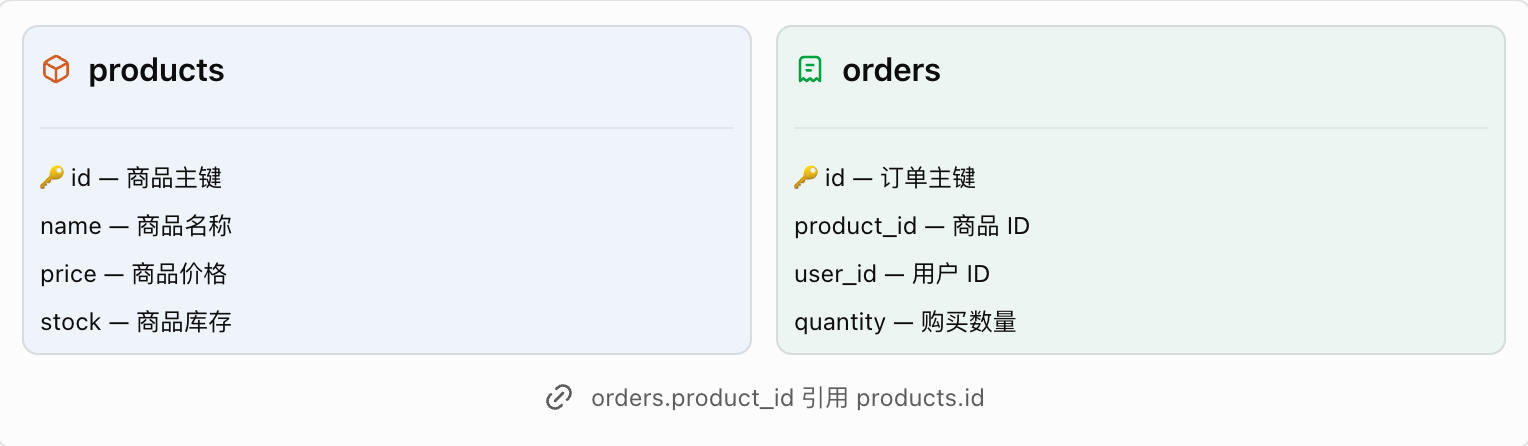
创建商品表
CREATE DATABASE IF NOT EXISTS shop
  CHARACTER SET utf8mb4;

USE shop;

CREATE TABLE products (
    id BIGINT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    category VARCHAR(30) NOT NULL,
    price DECIMAL(10, 2) NOT NULL,
    stock INT NOT NULL DEFAULT 0,
    CHECK (price >= 0),
    CHECK (stock >= 0)
) ENGINE=InnoDB;
CREATE TABLE:创建一张表。
PRIMARY KEY:主键,不能为 NULL,并且值不能重复。
NOT NULL:这一列不允许为空。
DEFAULT 0:插入记录时没有提供库存,则默认值为 0。
CHECK (stock >= 0):数据库层面的约束,不允许出现负库存。这在 MySQL 8.0.16 及更新版本中会实际执行。
ENGINE=InnoDB:选择 InnoDB 存储引擎。后面的事务、行锁和 B+ 树索引,都会以 InnoDB 为例。
创建订单表
CREATE TABLE orders (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id BIGINT NOT NULL,
    product_id BIGINT NOT NULL,
    quantity INT NOT NULL,
    unit_price DECIMAL(10, 2) NOT NULL,
    status VARCHAR(20) NOT NULL DEFAULT 'created',
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,

    FOREIGN KEY (product_id) REFERENCES products(id),
    INDEX idx_orders_user_time (user_id, created_at)
) ENGINE=InnoDB;
有一个细节:为什么订单里要保存unit_price,而不是每次读取商品表中的price?因为商品价格会改变,但历史订单必须保留用户下单时的价格,这个设计叫作保存价格快照。
事务:为什么两个人会买到最后一件商品?
1. 先看一个看起来没问题的程序
假设无线耳机只剩最后一件,库存为 1,用 Python 写一个简单的购买逻辑:
def buy_product(product_id):
    stock = get_stock(product_id)

    if stock > 0:
        create_order(product_id)
        update_stock(product_id, stock - 1)
        return "购买成功"

    return "库存不足"
如果只有一个用户购买,这段代码看起来没什么问题,但是,如果有两个用户同时购买呢?
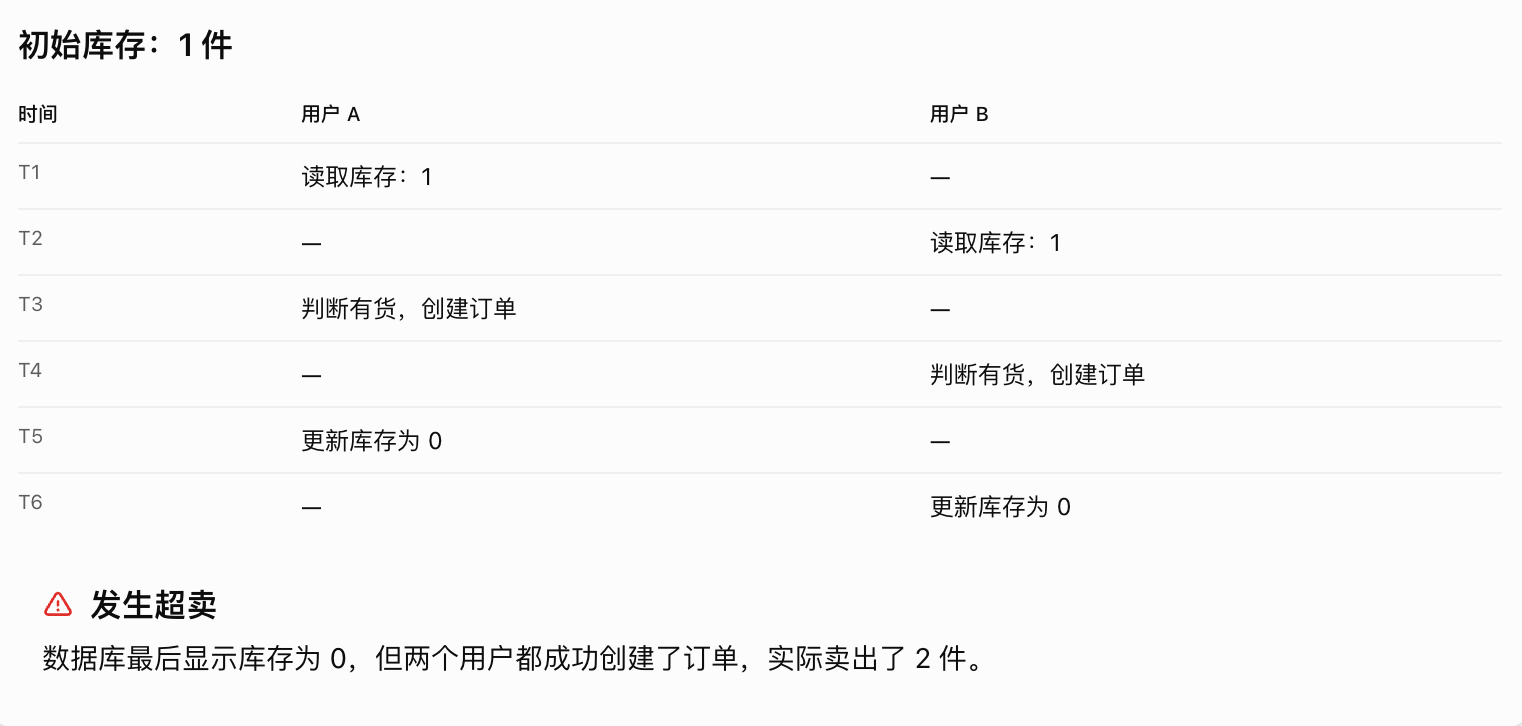
这是典型的竞态条件(Race Condition):程序的正确性取决于多个操作的执行时序。
2. 什么是事务(Transaction)?
事务可以理解为一组需要共同成功或共同失败的数据库操作。
假设用户购买一件商品,涉及两个步骤:
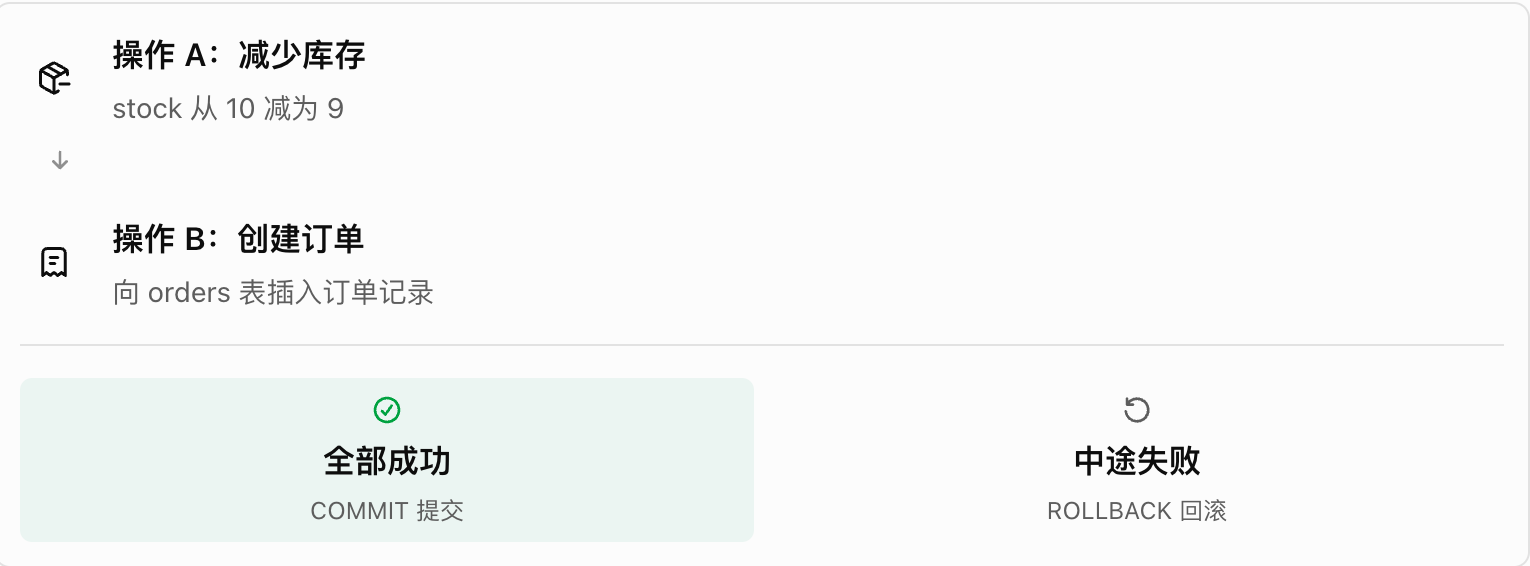
如果库存已经减少,但是订单创建失败了,就应该撤销库存修改,这就是事务最直观的作用:保证相关操作作为一个整体执行。
3. 事务的 ACID 四大特性
| 特性 | 含义 | 例子 |
|---|---|---|
| A — Atomicity 原子性 | 一组操作要么全部提交,要么全部回滚 | 不能扣了库存却没生成订单 |
| C — Consistency 一致性 | 事务执行前后要满足数据约束和业务不变量 | 不允许负库存、无效外键 |
| I — Isolation 隔离性 | 并发事务之间的相互影响受到隔离规则约束 | 避免一个事务错误依赖另一个事务的中间状态 |
| D — Durability 持久性 | 事务成功提交后,数据具备持久保存保证 | 提交完成后服务进程崩溃,订单不应因此消失 |
注意:ACID 中的一致性,并不代表数据库会自动保证任何业务规则。例如不超卖仍需要我们设计正确的 SQL 和事务逻辑。
4. 真正解决超卖:原子更新 + 事务
回到库存问题,原来的错误思路是:
先查询库存,再根据查询结果修改库存。
应该把“检查库存是否足够”和“扣减库存”放在同一条 SQL 里完成:
UPDATE products
SET stock = stock - 1
WHERE id = 101 AND stock >= 1;
SET stock = stock - 1:在数据库中根据当前库存扣减,而不是用 Python 之前读取的旧数值覆盖。
AND stock >= 1:只有剩余库存至少一件时,才允许更新。
在 InnoDB 中,针对同一商品行的并发`UPDATE`会受到行锁等并发控制机制约束。
如果原本只有 1 件库存,两个请求同时执行上述语句,正常情况下只有一个请求能成功扣减,另一个在获得执行机会后不再满足 stock >= 1,因此更新 0 行。
START TRANSACTION;

UPDATE products
SET stock = stock - 1
WHERE id = 101 AND stock >= 1;

SELECT ROW_COUNT() AS affected_rows;
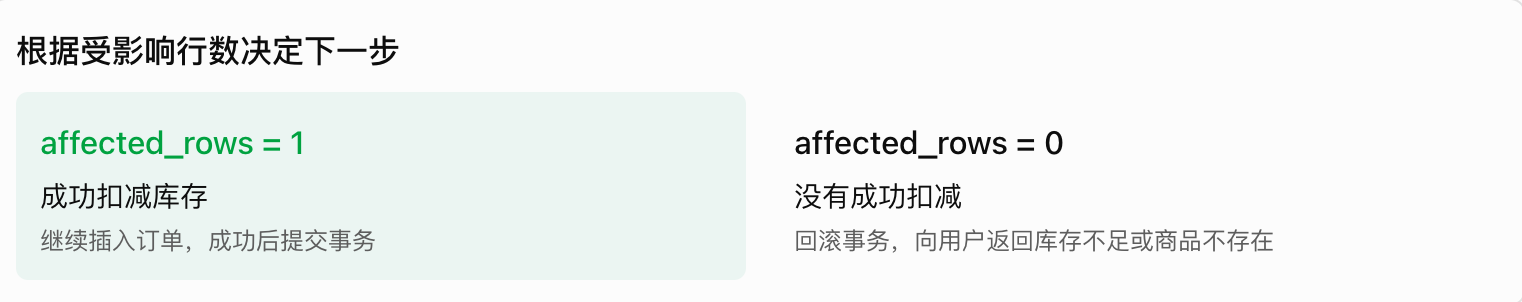
假如返回 1,就继续执行:
INSERT INTO orders
(user_id, product_id, quantity, unit_price, status)
VALUES
(7, 101, 1, 299.00, 'created');

COMMIT;
如果返回 0,则执行:
ROLLBACK;
这里的 COMMIT 和 ROLLBACK 是互斥分支,实际由后端程序根据 SQL 执行结果决定。如果插入订单失败,也必须回滚事务。
5. 那么锁是什么?
如果业务逻辑必须先读库存和价格、做判断,再执行修改,也可以使用:
START TRANSACTION;

SELECT stock, price
FROM products
WHERE id = 101
FOR UPDATE;
`FOR UPDATE` 是锁定读。在这个场景中,InnoDB 会对匹配的商品记录加锁,在事务结束前,其他需要获取冲突锁的事务必须等待。
不过要记住,锁定读必须配合正确的事务边界使用。事务如果太长,还会增加锁竞争,降低系统吞吐量,对于刚才的单商品库存扣减,使用带条件的原子 UPDATE 往往更直接。
为什么有事务仍然可能超卖?
考虑下面这段伪代码:
begin_transaction()

stock = get_stock(101)

if stock > 0:
    create_order(101)
    set_stock(101, stock - 1)

commit()
问题:已经使用了事务,为什么仍然可能出现超卖?
因为 事务的原子性不等于业务判断的并发安全性。
在常见的隔离级别下,两个事务仍可能通过普通
SELECT各自读取库存为 1,之后两边都创建订单,并尝试把库存更新为 0,即使这些 SQL 被包裹在事务里,也不意味着这段业务逻辑自动正确。解决办法是使用带库存条件的原子
UPDATE,或者在事务里通过SELECT ... FOR UPDATE等机制正确加锁并验证库存。这体现了一个重要的后端思想:不是使用了事务就一定安全,而是需要正确设计事务中的操作。
索引:为什么 MySQL 能快速找到数据?
1. 没有索引会怎么样?
假设有一张用户表,包含 100 万条记录,现在执行:
SELECT *
FROM users
WHERE id = 888888;
如果 id 没有索引,MySQL 可能需要逐行检查大量记录,直到找到符合条件的数据,这叫全表扫描(Full Table Scan)。
但如果 id 建立了合适的索引,数据库可以利用索引快速定位目标记录,避免逐行检查整个表。
2. 索引像一本书的目录
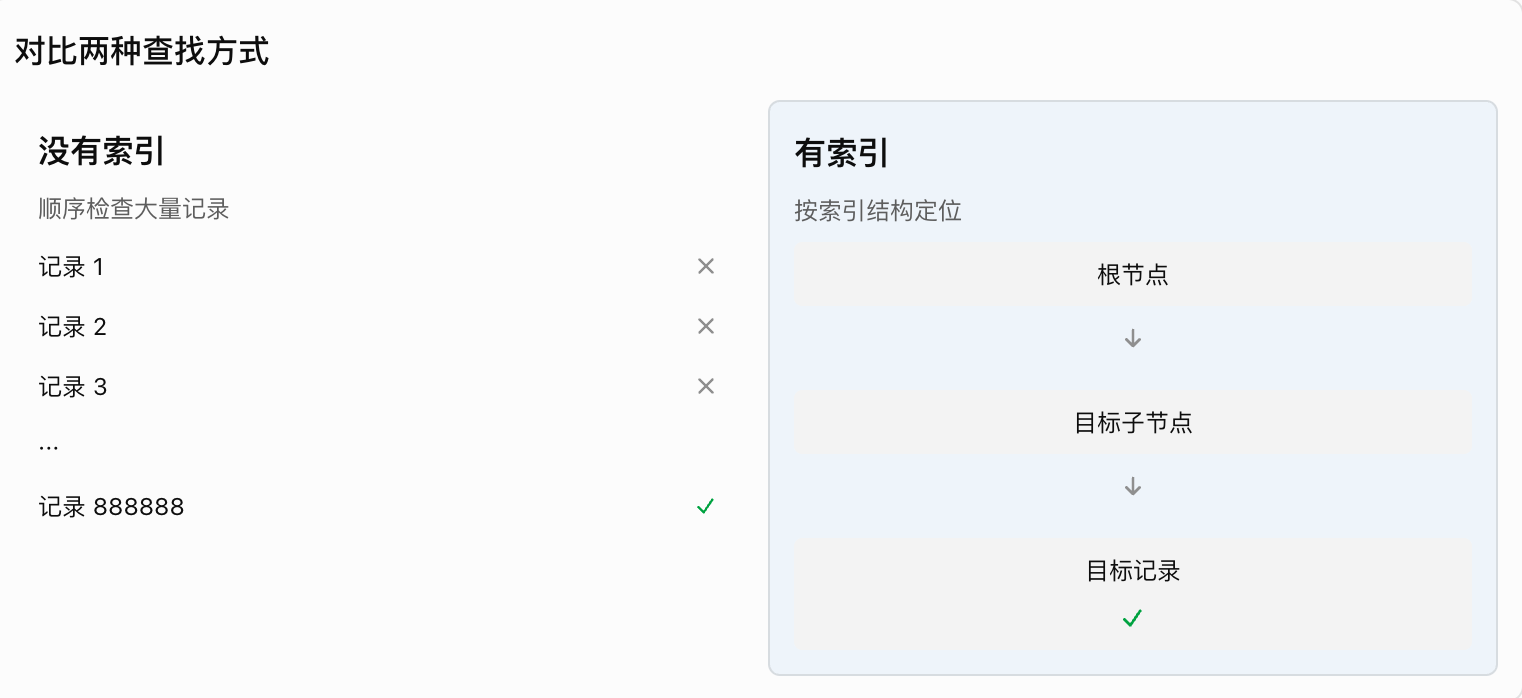
InnoDB 最常见的索引结构是 B+ 树(B+ Tree),它是一种平衡的多路搜索树,可以通过少量层级定位记录,也适合范围查询。
WHERE id = 888888是等值查询。WHERE price BETWEEN 100 AND 500是范围查询。 B+ 树的有序结构能够同时支持这两类查询,而且叶子节点之间便于进行连续的范围扫描。
3. 如何创建索引?
假设经常按照商品类别和价格查询:
SELECT id, name, price
FROM products
WHERE category = '数码'
  AND price < 400
ORDER BY price ASC;
可以建立一个联合索引:
CREATE INDEX idx_products_category_price
ON products(category, price);
索引结构中先按 category 组织数据,再在相同类别内按 price 组织,查询利用该索引快速定位数码类商品,再扫描价格符合条件的数据。
4. 联合索引的最左前缀原则
假设创建了索引:
INDEX (user_id, created_at)
| user_id | created_at | order_id |
|---|---|---|
| 7 | 10月15日 | 1001 |
| 7 | 10月16日 | 1002 |
| 8 | 10月14日 | 1003 |
| 9 | 10月17日 | 1004 |
这个联合索引首先按照 user_id 组织,再按照 created_at 排列同一用户的记录,它特别适合这样的需求:
SELECT id, product_id, created_at
FROM orders
WHERE user_id = 7
ORDER BY created_at DESC
LIMIT 10;
这意味着数据库可以快速找到用户 7 的订单,再按时间顺序获取最近的记录。
但如果只写下面这个,那索引通常就不那么合适了:
SELECT *
FROM orders
WHERE created_at >= '2026-10-01';
首先按照 user_id 排序,而不是把所有用户的 created_at 全局排列在一起。MySQL 的优化器在某些情况下仍可能采用特殊的索引访问方式,但不能指望它像按 created_at 为首列的索引一样高效,这就是所谓的最左前缀原则。
5. 索引越多越好吗?
索引虽然能提高某些查询的性能,但也会带来成本。
| 好处 | 代价 |
|---|---|
| 加快等值查询 | 需要额外存储空间 |
| 加快范围查询 | 插入数据时需要维护索引 |
| 某些情况下避免额外排序 | 修改、删除数据时可能产生额外开销 |
| 支持唯一性约束 | 索引过多会增加维护和优化成本 |
索引不是根据字段数量随意创建的,而应该根据真实业务查询来设计。
6. 如何判断 MySQL 有没有使用索引?
使用 EXPLAIN:
EXPLAIN
SELECT id, product_id, created_at
FROM orders
WHERE user_id = 7
ORDER BY created_at DESC
LIMIT 10;
EXPLAIN会展示 MySQL 优化器预计采用的查询执行计划。
| 字段 | 需要看什么 |
|---|---|
type |
访问方式,例如 ALL 代表全表扫描,ref 代表使用非唯一索引进行匹配 |
key |
实际计划使用哪个索引 |
rows |
预计需要检查的行数 |
Extra |
其他执行信息,例如是否需要额外排序 |
这里要注意:即使存在索引,MySQL 也不一定使用它,优化器会根据表大小、数据分布和成本估算决定执行计划。