当网站有十万甚至百万用户同时访问时,只依靠 MySQL,系统还能高效运行吗?
本节的目标是:
- 理解 Redis 的工作原理,以及它和 MySQL 的区别。
- 掌握 Redis 最常见的数据结构与命令。
- 理解缓存、缓存命中、缓存过期以及 Cache Aside。
- 理解缓存穿透、缓存击穿和缓存雪崩。
- 使用 Python + Redis + MySQL,实现一个真正的缓存查询功能。
为什么需要 Redis?
继续使用之前的电商系统,假设网站里有一款热门无线耳机。
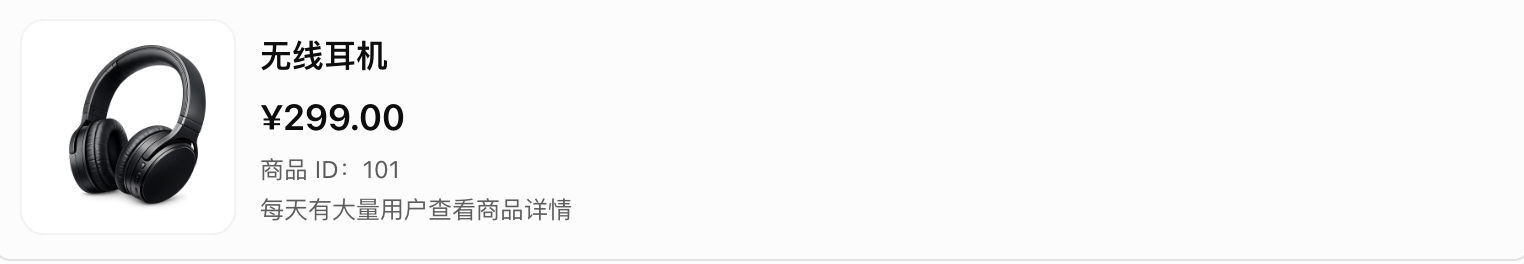
每次打开商品详情页,Python 后端都会执行:
SELECT id, name, price, stock
FROM products
WHERE id = 101;
一秒钟有 10,000 个请求,全部查询这款耳机,如果所有请求都直接访问 MySQL,就会对数据库造成较大压力。
明明建立了索引,查询不是已经很快了吗?
索引能减少查找数据的成本,但是索引并不能消除每次请求带来的数据库查询、网络通信、连接管理、CPU 和内存访问成本。
即使一条查询很快,当调用次数特别多时,资源消耗仍然可能非常可观。
换一种思路
💡既然这款耳机的名称和价格短时间内不会频繁变化,为什么每次都要查询数据库?
不如第一次从 MySQL 查询之后,把结果临时保存起来,下次有人请求相同的数据,直接返回已经保存的结果。
Redis 为什么快?
Redis 是一个以内存数据操作为核心的键值数据存储系统,先对比内存和磁盘。
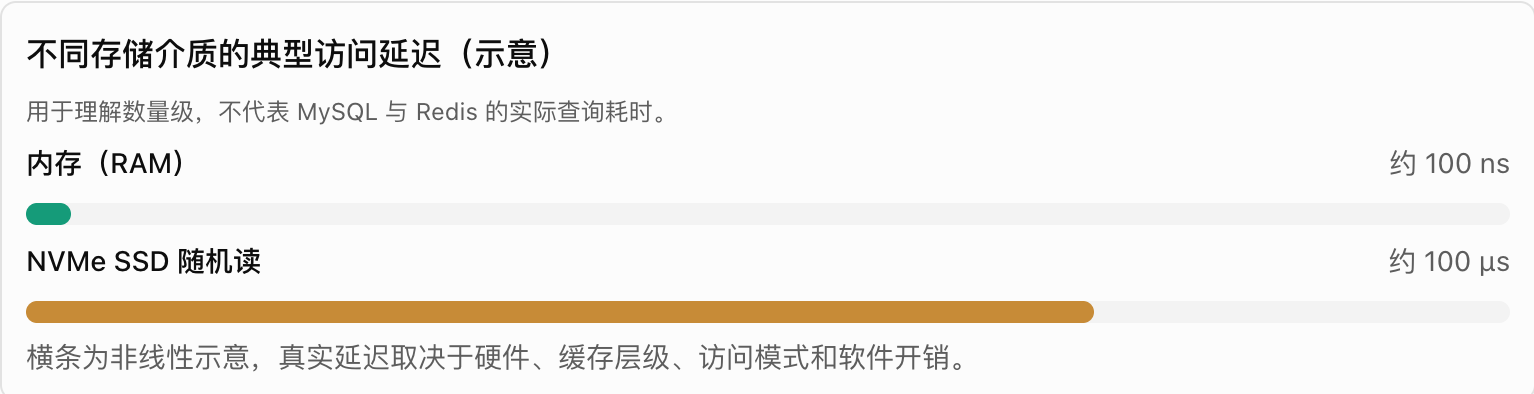
MySQL 不是每次查询都从磁盘读取,Redis 快也不只是因为它把数据放在内存里,MySQL 的 InnoDB 有 Buffer Pool,可以把经常使用的数据页缓存在内存中。
Redis 的性能优势还来自:
适合高频访问的内存数据结构。
相对简洁的命令处理模型。
单条命令通常能够高效完成,避免复杂 SQL 查询规划。
Redis 核心命令执行通常采用串行化的处理方式,减少命令执行过程中的复杂锁竞争。
Redis 也能通过 RDB 快照、AOF 日志等机制进行持久化,因此它不是一个“只能存在内存,重启就必然丢数据”的工具。
不过在电商例子中,仍然把 MySQL 作为商品数据的权威来源,Redis 只负责加速读取。
Redis 最基础的概念:Key-Value
Redis 最基本的访问方式是通过 Key(键)找到 Value(值),可以先将它类比为 Python 的字典。
data = {
    "product:101": "无线耳机",
    "product:102": "机械键盘"
}

print(data["product:101"])
SET product:101 "无线耳机"
GET product:101
返回:"无线耳机"
虽然看起来像字典,但 Redis 是独立运行的服务,其他进程、机器的应用也可以通过网络访问。
1. 为什么 Key 要写成 product:101?
Redis 的 Key 本质上是字符串类型的标识。
约定:
product:101代表 ID 为 101 的商品。
user:7代表 ID 为 7 的用户。
order:1001代表订单 1001。
这种命名方式方便管理不同类型的数据, 冒号只是惯用的命名约定,Redis 并不会自动把它解析成目录结构。
2. Redis 有哪些数据类型?
Redis 不只能存字符串,也支持多种数据结构。
| 数据类型 | 使用场景 | 典型命令 |
|---|---|---|
| String | 商品缓存、计数器、Token | GET、SET |
| Hash | 用户信息、对象字段 | HSET、HGET |
| List | 简单列表、任务队列 | LPUSH、RPOP |
| Set | 去重、标签、集合操作 | SADD、SISMEMBER |
| Sorted Set | 排行榜、带分数的排序 | ZADD、ZREVRANGE |
| Stream | 消息流、消费组 | XADD、XREADGROUP |
场景 A:文章浏览次数统计
SET article:101:views 100

INCR article:101:views

GET article:101:views
结果是 101, INCR 能将一个整数值原子地加 1, 这比先执行 GET,再由 Python 计算 +1,最后 SET 回去更适合并发计数,因为后者可能出现丢失更新。
场景 B:论坛热度排行榜
ZADD posts:ranking 100 post:101
ZADD posts:ranking 250 post:102
ZADD posts:ranking 180 post:103

ZREVRANGE posts:ranking 0 2 WITHSCORES
Redis 会根据分数维护排序, 如果我们开发的是一个论坛,Sorted Set 就可以用于帖子热度排行。
但要注意:排行榜评分规则仍由业务代码决定,Redis 只是提供高效的数据结构。
TTL:缓存为什么需要自动过期?
假设把商品价格缓存到 Redis:
SET product:101:price 299
商品降价了, MySQL 中的价格更新成 199 元,但 Redis 里仍然是 299 元, 这就发生了缓存数据过时, 为此Redis 提供 TTL(Time To Live),即过期时间。
SET product:101:price 299 EX 60
查询剩余时间:
TTL product:101:price
真实 Redis 中,执行 TTL key 时:
- 返回非负整数:剩余的过期秒数。
- 返回
-1:Key 存在,但没有设置过期时间。 - 返回
-2:Key 不存在,或已经过期。
返回值参见 Redis 官方 TTL 文档。
Cache Aside:后端最经典的缓存模式
现在把 MySQL 和 Redis 结合起来。
Cache Aside(旁路缓存)的核心逻辑非常简单:
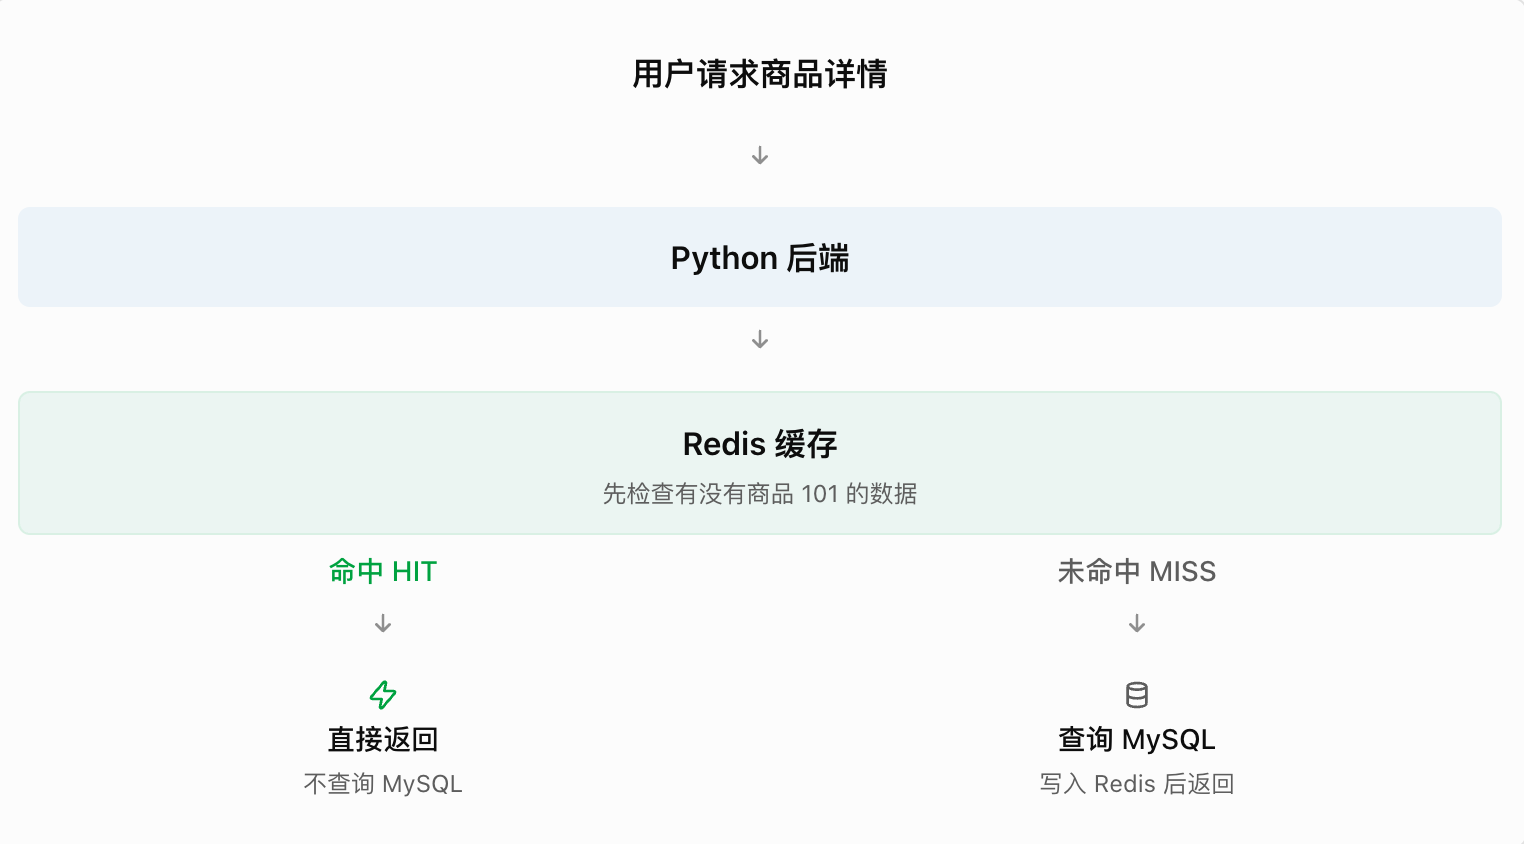
- 读数据:先查缓存,没有就查数据库,然后把数据写入缓存。
- 更新数据:先修改数据库,再删除对应缓存。
为什么更新数据库之后推荐删除缓存,而不是简单地同时修改 Redis?
一个原因是减少同时维护两份数据的复杂度;下次读取时就会从数据库重新填充缓存, 不过这并不能完全消除并发一致性问题。
一个例子:
import json

import redis
import mysql.connector

cache = redis.Redis(
    host="127.0.0.1",
    port=6379,
    decode_responses=True,
    socket_connect_timeout=2,
    socket_timeout=2,
)


def query_mysql(product_id: int):
    conn = mysql.connector.connect(
        host="127.0.0.1",
        port=3307,
        user="root",
        password="local_demo_only_123",
        database="shop",
        connection_timeout=3,
    )

    try:
        cursor = conn.cursor(dictionary=True)
        try:
            cursor.execute(
                """
                SELECT id, name, price, stock
                FROM products
                WHERE id = %s
                """,
                (product_id,),
            )
            product = cursor.fetchone()
        finally:
            cursor.close()
    finally:
        conn.close()

    if product is not None:
        product["price"] = str(product["price"])

    return product


def get_product(product_id: int):
    key = f"product:{product_id}"

    # 第一步:尝试从 Redis 获取数据
    try:
        cached = cache.get(key)

        if cached is not None:
            print("Redis HIT")
            return json.loads(cached)
    except (redis.RedisError, ValueError) as exc:
        print("缓存读取失败:", exc)

    # 第二步:从 MySQL 读取
    print("查询 MySQL")
    product = query_mysql(product_id)

    if product is None:
        return None

    # 第三步:将数据放进 Redis
    try:
        cache.set(
            key,
            json.dumps(product, ensure_ascii=False),
            ex=60,
        )
    except redis.RedisError as exc:
        print("缓存写入失败:", exc)

    return product


print(get_product(101))
print(get_product(101))
为什么需要异常处理?
想象 Redis 突然宕机, 如果代码没有处理异常,Redis 连接失败可能直接导致整个商品接口返回错误, 在这个例子中,Redis 只是加速层, 因此可以设计为:Redis 访问失败 → 降级查询 MySQL。
这种降级并非总是安全, 大量流量同时回源可能冲垮 MySQL,实际服务还可能需要限流、熔断和请求合并。
缓存是性能优化,不能让它反过来成为整个系统唯一的故障点。
假设用户打开商品详情页,Redis 中保存的价格为 299 元, 后台管理员修改了 MySQL,将价格改成 199 元。
问题:此时用户再次打开商品详情页,可能看到多少钱?怎样尽量减少这种不一致?
可能仍然看到 299 元,因为 Redis 里保留着旧价格。
一个常见的处理流程是:
- 修改 MySQL 中的商品价格。
- MySQL 事务成功提交。
- 删除 Redis 对应的
product:101缓存。- 下一次查询从 MySQL 获取新的价格,重新缓存。
不过,数据库提交和缓存删除是两个独立操作, 如果删除失败,或者遇到并发读取与更新交错,仍可能出现短暂不一致。因此高一致性业务还需要更完整的机制。
尤其是支付金额绝不能只依赖商品详情页缓存的数据,应以服务端订单和支付逻辑中的权威数据为准。
Redis 经典面试问题:缓存三兄弟
1. 缓存穿透(Cache Penetration)
假设有人不停请求根本不存在的商品:
GET /products/999999999Redis 里没有, MySQL 里也没有。
下一次继续请求,Redis 里还是没有,MySQL 又被查询一次。
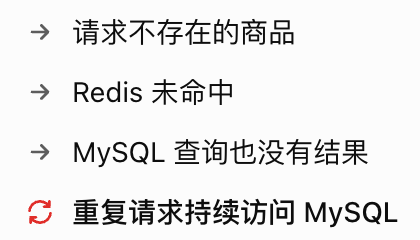
解决思路之一:缓存空值。
例如商品不存在,也向 Redis 写入一个短时间有效的特殊值,避免反复访问 MySQL。
还可以使用参数校验、布隆过滤器等方法减少无效查询。
2. 缓存击穿(Cache Breakdown)
假设商品 101 特别热门, 大量用户反复访问它,Redis 原本有缓存, 突然这个热门商品的缓存过期了, 同一时刻有数千个请求到达, 它们发现 Redis 没有数据,全部去访问 MySQL。
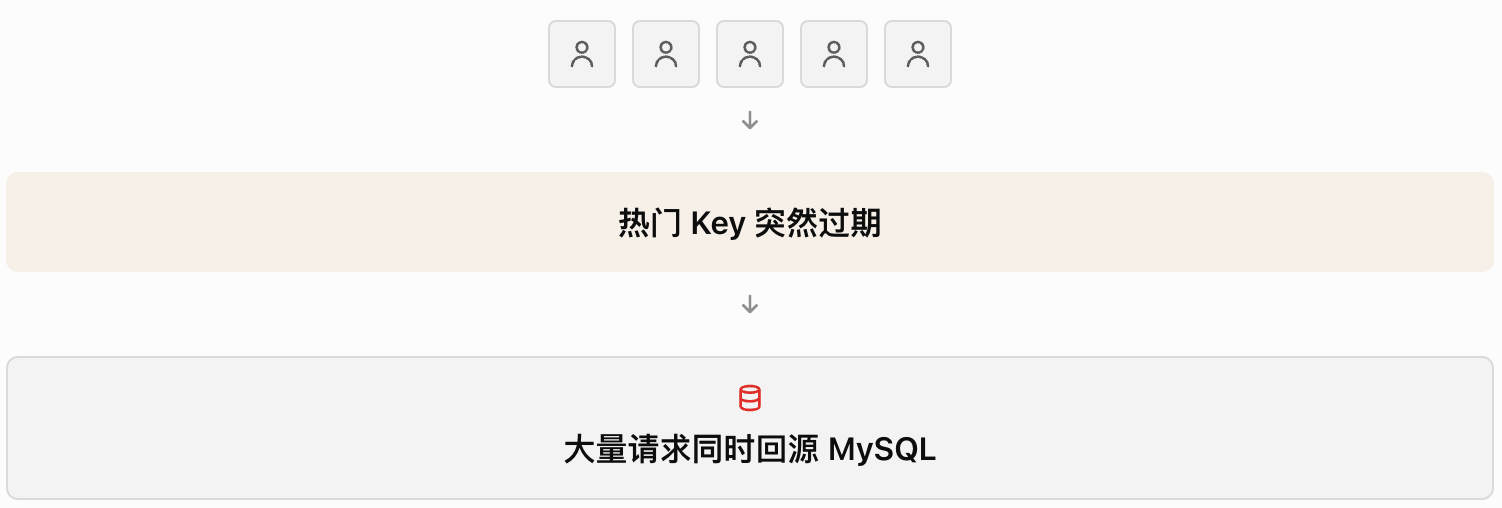
常见解决思路是请求合并,例如让一个请求负责重新加载热点数据,其他请求等待结果, 也可以根据业务场景使用逻辑过期、后台刷新等策略。
3. 缓存雪崩(Cache Avalanche)
与缓存击穿不同,雪崩通常涉及大量缓存同时失效,或者缓存服务整体不可用。例如我们把 10 万个商品缓存全部设置为 60 秒过期, 恰好在同一时间创建这些缓存,就可能在 60 秒后集中失效, 很多不同商品的请求都需要查询数据库。
一种常见的缓解方法是给 TTL 增加随机抖动:
import random

ttl = 60 + random.randint(0, 30)

cache.set(
    "product:101",
    "商品数据",
    ex=ttl,
)
真实的雪崩保护还需要考虑 Redis 高可用、限流、熔断和数据库承载能力。
三种问题放在一起比较
| 问题 | 主要原因 | 典型应对 |
|---|---|---|
| 缓存穿透 | 请求的数据根本不存在 | 缓存空值、校验、布隆过滤器 |
| 缓存击穿 | 单个热点 Key 失效 | 请求合并、互斥重建、逻辑过期 |
| 缓存雪崩 | 大量 Key 失效或缓存整体故障 | TTL 随机化、高可用、限流降级 |
再往深处思考:Redis 为什么能处理并发计数?
前面讲 MySQL 时曾经讨论两个用户同时更新库存的超卖问题。
现在考虑另一个场景, 有一个论坛,每当有人浏览帖子,就让浏览次数加 1。
假设同时有 100 个用户打开这个帖子, 如果采用下面的 Python 逻辑:
count = int(cache.get("post:101:views"))

count += 1

cache.set("post:101:views", count)
多个请求可能同时读取旧值 100,然后都计算得到 101,最后覆盖彼此的结果, 这是丢失更新问题。
Redis 提供的 INCR 是单条原子命令。
INCR post:101:views
并发请求不会在这条命令内部交错执行,因此能够避免读—改—写竞态, 不过如果计数还需要可靠同步到 MySQL,仍然需要设计数据持久化与同步机制。
这也引出了一个很重要的结论:
Redis 的单条命令通常具有原子性,但多条命令的组合不自动具有事务级的原子性。
所以限流器、分布式锁时,还会遇到 Lua 脚本、
SET NX、过期时间和并发控制等知识。